Gérer les runners
La page Runners centralise le parc d'exécution : statuts en temps réel, santé de chaque machine, clusters de répartition et runner par défaut.
La liste des runners
La page affiche d'abord une barre de compteurs : runners en ligne (une exécution en cours), idle (connectés, sans exécution) et hors ligne, puis les runners eux-mêmes, en vue cartes ou vue tableau (bascule en haut à droite).
Filtrez la liste par :
- Portée : utilisateur, entreprise ou tous ;
- Statut : en ligne, idle, hors ligne ;
- Recherche : nom, description ou identifiant.
Chaque carte montre :
- le nom, le statut et la portée du runner ;
- la ligne « host » : OS/architecture, version du binaire et nom de machine ;
- l'exécution en cours (avec lien direct vers son suivi) ou le dernier battement de cœur si le runner est hors ligne ;
- les statistiques : CPU et RAM moyens par exécution, exécutions sur 24 h.
La liste se met à jour en direct : dès qu'un runner se connecte ou se déconnecte, son statut change sans recharger la page.
Actions sur un runner
Depuis le bouton Logs et le menu ⋮ d'une carte :
| Action | Effet |
|---|---|
| Logs / Historique | Ouvre le suivi des exécutions filtré sur ce runner |
| Définir par défaut | Marque le runner (étoile) comme cible proposée par défaut |
| Modifier | Modifie le nom et la description |
| Partager | Gère les accès d'un runner d'entreprise |
| Ré-enregistrer | Génère un nouveau code d'enregistrement (voir Enregistrer un runner) |
| Supprimer | Retire le runner de la plateforme |
La page de détail
Cliquer sur une carte ouvre /runners/<uuid>, la vue santé du runner.
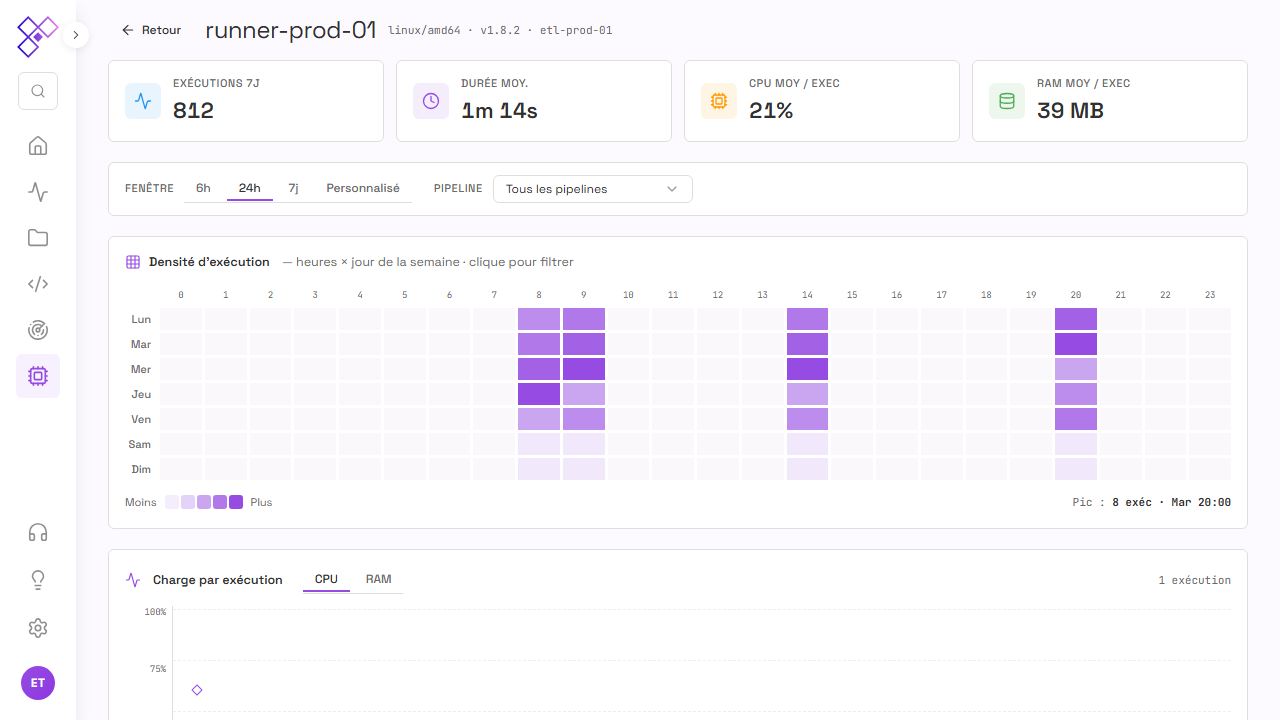 Indicateurs sur 7 jours, densité d'exécution, charge par exécution et
répartition par pipeline.
Vous y trouvez :
- des indicateurs : exécutions sur 7 jours, durée moyenne, CPU et RAM moyens par exécution ;
- une fenêtre temporelle réglable (6 h, 24 h, 7 j ou dates personnalisées) et un filtre par pipeline ;
- la densité d'exécution : heatmap heures × jours de la semaine ; cliquez sur une case pour filtrer le reste de la page sur ce créneau ;
- la charge par exécution : une barre par exécution (moyenne CPU ou RAM, marqueur de pic) ; cliquer sur une barre ouvre le détail de l'exécution ;
- le tableau des pipelines exécutés sur ce runner : runs, durée moyenne, CPU/RAM moyens et max, dernier run ;
- le redémarrage automatique, détaillé ci-dessous.
Redémarrage automatique
Un runner qui tourne des semaines finit par accumuler ce qu'aucun correctif ne rattrape à chaud. Le redémarrage périodique y répond, mais il doit être placé là où il dérange le moins — d'où un créneau choisi, et non imposé.
Le panneau Redémarrage automatique propose, à côté des réglages, les créneaux les plus calmes déduits de l'activité réellement observée sur trente jours. Cliquer sur l'un d'eux renseigne le jour et l'heure.
La fenêtre temporelle de la page descend à six heures : elle ne dit rien d'une habitude hebdomadaire. Trente jours donnent quatre occurrences de chaque créneau, assez pour distinguer une régularité d'un accident.
Le classement ne retient pas la seule heure visée mais son voisinage. Une heure vide coincée entre deux heures chargées serait un mauvais conseil : un traitement lancé juste avant déborderait sur elle.
Traitements en cours
Deux décisions se combinent à l'heure dite.
| Réglage | Effet |
|---|---|
| Les laisser finir | le redémarrage attend la fin des traitements |
| Les interrompre | le redémarrage a lieu, les traitements sont coupés |
| Attendre au plus N minutes | plafond de cette attente ; 0 = sans limite |
| Passé ce délai : reporter | le redémarrage est renvoyé à la prochaine occurrence |
| Passé ce délai : interrompre | les traitements restants sont coupés |
Attendre sans limite et ne jamais interrompre : si un traitement tourne toujours à l'heure dite, le redémarrage n'aura pas lieu. C'est un choix licite — un traitement tronqué coûte souvent plus cher qu'un redémarrage manqué — mais le runner n'est pas en panne pour autant. L'interface le signale.
Nouveaux traitements
Le runner peut cesser d'accepter de nouveaux traitements à l'approche de l'heure. Sans ce délai d'anticipation, un traitement lancé à la dernière minute repousserait le redémarrage de toute sa durée.
Pendant cette période, le runner apparaît sain mais ne prend plus de travail : c'est voulu, et la page de détail comme le gestionnaire le disent explicitement.
Fuseau horaire
L'heure s'entend dans le fuseau indiqué, pas en UTC. « 3 h » reste donc 3 h de part et d'autre d'un changement d'heure, et un runner posé sur un autre continent redémarre à l'heure qu'on a voulue pour lui.
Web, gestionnaire : un seul réglage
Le réglage se modifie indifféremment depuis cette page ou depuis le gestionnaire de runners. La plateforme en est la seule dépositaire : il n'existe pas deux réglages qui pourraient diverger.
Le runner le tire et le garde en cache — il continue de l'appliquer même coupé du serveur, ce qui est justement le cas où l'on ne peut plus intervenir à la main. En contrepartie, un réglage modifié pendant qu'un runner est hors ligne ne prend qu'à sa reconnexion : le gestionnaire signale alors l'écart au lieu de le masquer.
Clusters de runners
Un cluster regroupe plusieurs runners d'entreprise derrière une même cible, avec une stratégie de répartition de charge. Ouvrez Clusters en haut de la page Runners pour les gérer : nom, description, stratégie (round-robin, aléatoire ou le moins chargé) et membres.
Un environnement de projet peut alors cibler le cluster plutôt qu'un runner unique : les exécutions sont réparties entre les membres connectés.
Journaux d'exécution gardés en local
Le runner écrit le journal de chaque exécution sur son propre disque, au fil de l'eau, puis l'envoie à la plateforme. Quand l'envoi réussit, il le supprime.
Restent donc ceux qui n'ont jamais pu partir — serveur injoignable, poste coupé du réseau. Ce sont leurs seules copies : c'est la raison d'être de ce fichier, et pourquoi le runner n'y touche qu'à regret.
Trois bornes, réglables
Le runner fait son ménage tout seul, toutes les heures par défaut. Trois règles, appliquées dans cet ordre, et chacune se désactive en la mettant à zéro :
| Variable | Défaut | Ce qu'elle borne |
|---|---|---|
FLUHOMS_JOURNAUX_RETENTION_HEURES | 168 (7 jours) | L'âge au-delà duquel un journal est oublié. |
FLUHOMS_JOURNAUX_BUDGET_MO | 512 | La taille totale du dossier des journaux. |
FLUHOMS_JOURNAUX_ESPACE_LIBRE_MIN_MO | 1024 | Le plancher de place libre sur le volume. |
FLUHOMS_JOURNAUX_ENTRETIEN_MINUTES | 60 | La cadence du ménage. |
L'âge ne voit pas venir un seul run bavard : dix heures de traitement produisent à elles seules plus que sept jours de runs ordinaires, et tous ces journaux sont récents. D'où le budget.
Et le budget ne connaît pas le reste du disque. Si le volume descend sous le plancher, c'est la machine qui est en danger, pas seulement la journalisation : les journaux passent alors après tout le reste, et sont supprimés jusqu'à repasser au-dessus.
Dans les trois cas, le ménage supprime du plus ancien au plus récent : le plus récent est celui qu'on a le plus de chances de pouvoir encore envoyer, et celui qu'on ira lire si l'on cherche ce qui vient de se passer. Chaque suppression est consignée dans le journal du runner, avec la règle qui l'a décidée.
Purger à la main
Quand un poste n'a plus de place et qu'on veut la récupérer tout de suite, l'onglet Zone de danger du runner propose Purger les journaux.
Il n'arbitre pas, il obéit — d'où sa place dans cet onglet. Ce qui est déjà sur la plateforme n'est pas concerné ; ce qui part ici ne revient pas.
Runner par défaut
L'étoile marque votre runner par défaut : il est proposé en premier lorsqu'une cible d'exécution doit être choisie. Vous pouvez le définir ou le retirer depuis le menu ⋮ de n'importe quel runner.
Et ensuite ?
- Configuration du runner : variables d'environnement du binaire ;
- CLI du runner : commandes
serve,status,update…