Qualité de données et supervision
Ce que vous allez construire
Un pipeline de contrôle qualité : la méga-brick Qualité marque les lignes non conformes, une brick Route sépare les valides des rejets, une Assertion fait échouer le pipeline si les rejets dépassent un seuil, et un Instantané capture le flux reçu pour le debug. Les rejets sont écrits dans un fichier séparé. Vous analyserez ensuite l'exécution en détail (logs par brick, timeline) et mettrez en place le suivi au quotidien via le lobby et le monitoring.
- Un projet et sa copie de travail dans le Studio (voir le tutoriel Du CSV à PostgreSQL, Étape 1) ;
- Une connexion storage contenant un CSV de test, par exemple
clients.csvavec des colonnesemailetmontant(glissez-y quelques valeurs volontairement invalides) ; - Un runner connecté.
Étape 1 : la source et l'instantané
Dans un nouveau pipeline « Contrôle qualité clients », posez :
- une Source fichier : votre connexion storage, format CSV, motif
clients*.csv; - une brick Instantané juste derrière, une action pass-through : le
flux ressort inchangé, mais son état est sauvegardé dans un storage.
Configuration : votre connexion storage, nom de fichier
clients_recus_${run.id}.parquet(la variable${run.id}produit un fichier par exécution), formatparquet.
L'Instantané capture l'état reçu de la source à chaque run : si un contrôle échoue plus loin, vous rejouez et comparez à partir de cette photo.
Étape 2 : les règles de conformité (méga-brick Qualité)
Ajoutez une brick Qualité et déclarez deux opérations validate, qui
marquent chaque ligne d'une colonne booléenne (mode flag) sans rien
supprimer :
| Opération | Paramètres |
|---|---|
validate sur email | check: regex, pattern: .+@.+, on_fail: flag, output_name: email_valid |
validate sur montant | check: range, min: 0, on_fail: flag, output_name: montant_valid |
Deux comportements à connaître (voir la référence Qualité) :
- pour
check: regex, le motif est ancré au début de la valeur ; - pour
check: range, les valeurs sont converties en numérique : une valeur non convertible est invalide.
En développement, préférez on_fail: flag pour inspecter les lignes rejetées ;
remove les supprimerait silencieusement du flux.
Étape 3 : router valides et rejets
Ajoutez une brick Route derrière la Qualité et déclarez deux routes (chaque route crée un port de sortie sur la brick) :
| Route | Condition (expression pandas) |
|---|---|
rejets | email_valid == False or montant_valid == False |
valides | email_valid == True and montant_valid == True |
Les routes sont évaluées dans l'ordre déclaré (first match) : une ligne part vers la première route dont la condition est vraie, jamais dupliquée. Toutes les lignes correspondant ici à l'une des deux routes, vous pouvez désactiver la Sortie par défaut (voir la référence Route).
Étape 4 : la branche des rejets (garde-fou et fichier)
Sur la sortie rejets, enchaînez :
- une brick Assertion, le garde-fou :
max_rows: 50. Si le flux de rejets compte plus de 50 lignes, le pipeline échoue en listant les violations ; en deçà, le flux ressort inchangé. Le seuil s'exprime en nombre de lignes : calez-le sur votre volumétrie ; - une brick Écriture fichier : votre connexion storage, format CSV,
nom de fichier
rejets_clients.
En fonctionnement normal, les rejets (sous le seuil) sont donc archivés dans un fichier séparé, prêts à être corrigés à la source. Si le seuil est dépassé, le pipeline s'arrête en erreur. C'est le comportement voulu d'un garde-fou : mieux vaut un échec franc que des données massivement mauvaises.
Pour notifier sans bloquer (par exemple dès le premier rejet), ajoutez une brick Alerte sur la même branche : les deux se combinent (voir la référence des Actions).
Étape 5 : la branche des valides
Sur la sortie valides, posez une Écriture fichier (clients_valides,
format CSV), ou une
Écriture base de données si
la suite de votre chaîne est en base.
Le pipeline complet : Source fichier → Instantané → Qualité → Route, puis
rejets → Assertion → Écriture fichier et valides → Écriture fichier.
Étape 6 : exécuter et analyser le détail
Lancez le pipeline depuis l'éditeur, puis ouvrez le run dans Monitoring :
- l'onglet Logs trace chaque brick : le décompte des lignes marquées par
les
validate, l'aiguillage des routes, l'écriture des fichiers ; filtrez par niveau (WARN,ERROR) ou cherchezrejetsen texte libre ; - l'onglet Métriques compare lignes lues et lignes sorties, avec le tableau par brique (statut, durée, CPU/RAM) ;
- la carte Étapes du panneau latéral montre la timeline du déroulé.
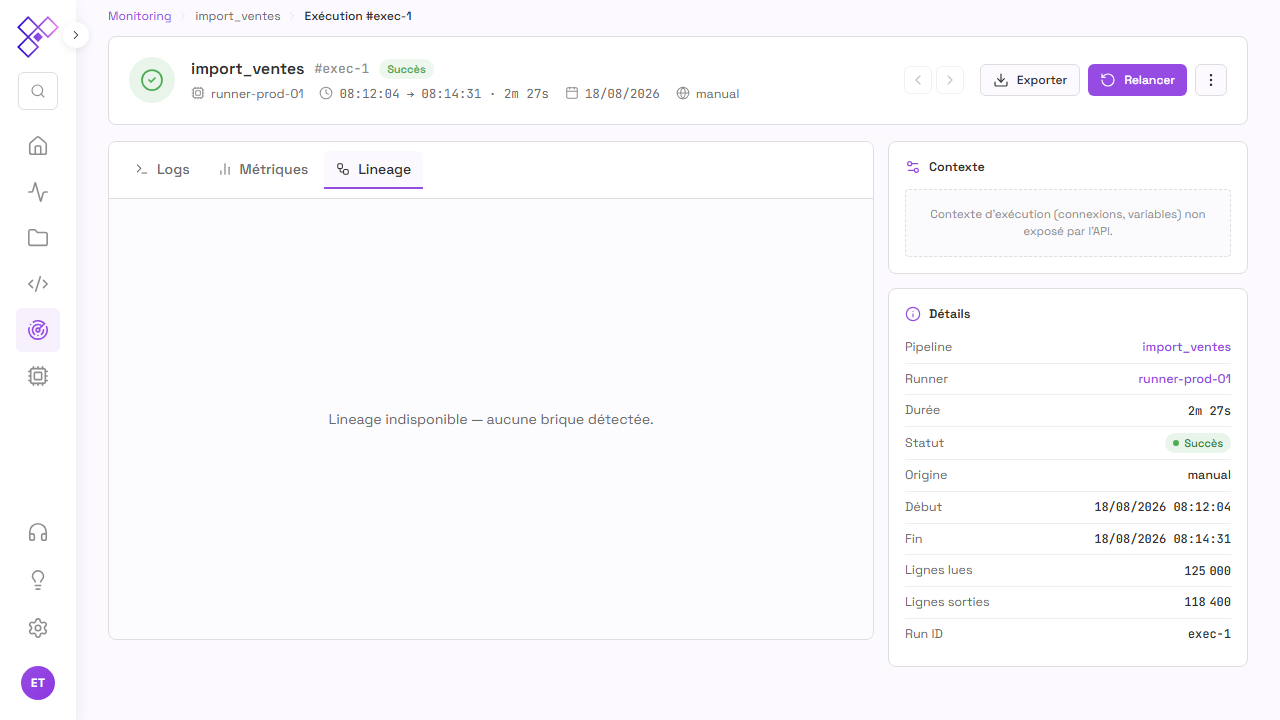 Chaque barre est une brick, positionnée et dimensionnée sur la durée totale
du run ; les deux branches du Route y sont visibles.
Pour voir le garde-fou en action, abaissez temporairement max_rows à 1 et
relancez depuis le détail du run : le pipeline échoue, la carte Erreur
remonte l'assertion violée et la brick fautive, et l'instantané de l'étape 1
vous donne le flux d'entrée exact à rejouer (voir
Détail d'une exécution).
Étape 7 : suivre au quotidien
Deux points d'observation complètent le dispositif :
- le lobby, votre page d'accueil : les KPIs du jour (pipelines OK, incidents actifs) et les widgets Alertes & incidents, Exécutions en cours ou Score de santé remontent d'un coup d'œil les échecs des dernières 24 h ;
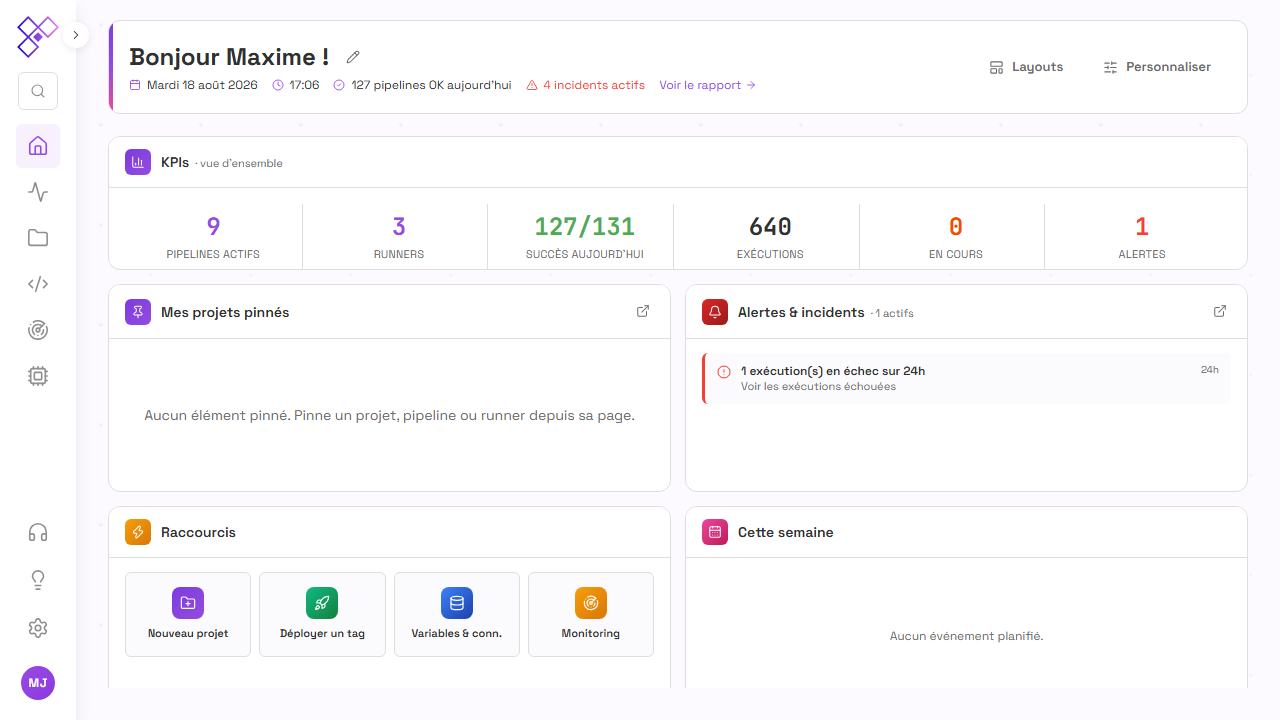 Le bandeau d'accueil et la grille de widgets, personnalisables et
partageables en layouts.
- le monitoring : la liste des exécutions, filtrable par statut, pour repérer les runs en erreur et ouvrir leur détail.
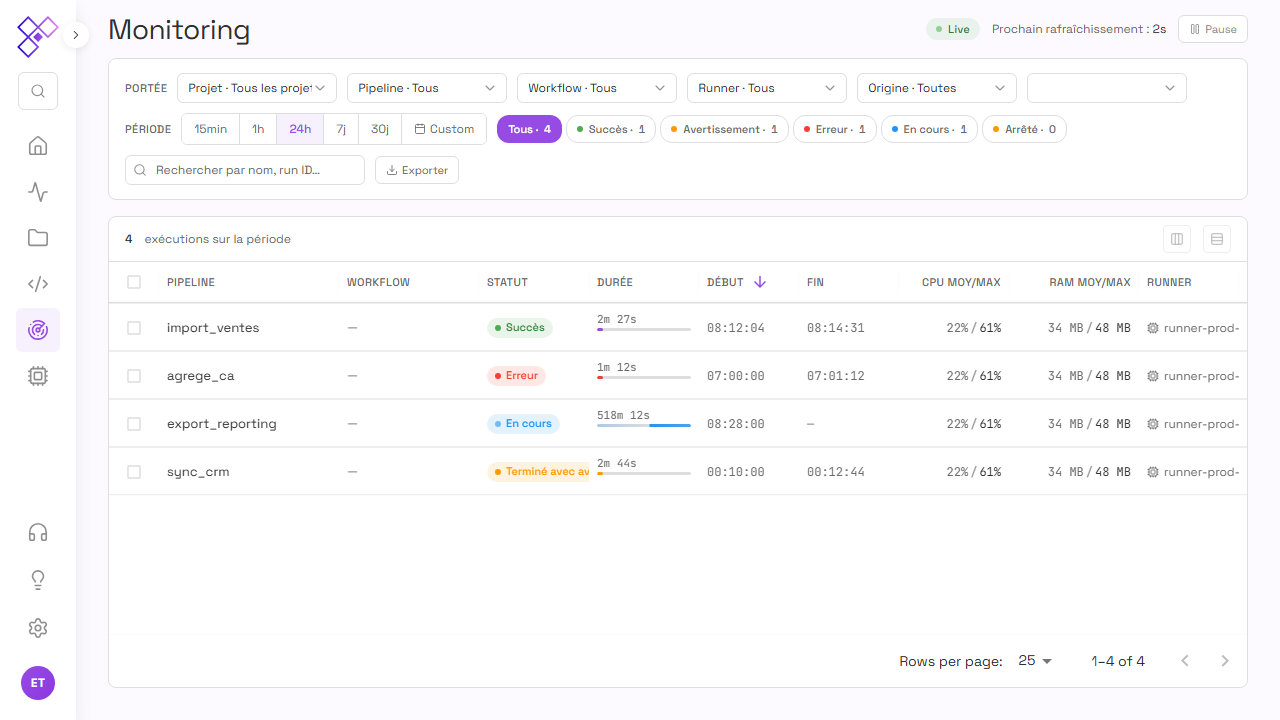 Chaque ligne est une exécution avec son statut, sa durée et son runner.
Une fois le pipeline commité, poussé et déployé, ce contrôle tourne sur les environnements avec leurs propres valeurs de connexions, et peut être planifié par un workflow, comme dans le tutoriel Ingestion d'API planifiée avec alertes.
Pour aller plus loin
- Qualité (référence) : toutes les règles
validateet l'opérationmatch. - Route (référence) : routes, ordre d'évaluation, sortie par défaut.
- Actions (référence) : Alerte, Assertion, Instantané, Étiqueter l'exécution.
- Détail d'une exécution : logs, métriques, lineage et contexte résolu.
- Le lobby : composer sa vue de supervision.